
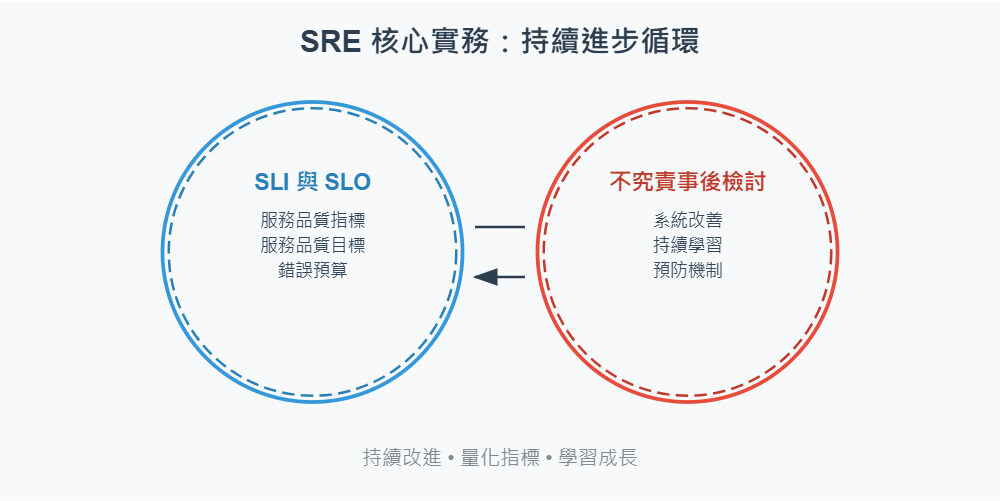
SRE 實務架構圖
追求 100% 可用性基本上是不可能的,成本也吃不消。SRE(Site Reliability Engineering)的核心觀念很直接:系統一定會壞,重點不是假裝它不會壞,而是用量化指標把「開發想衝新功能、維運想顧穩定」的矛盾講清楚。
01. SLI、SLO、SLA 到底差在哪
談穩定性不能只憑感覺,需要用數字把標準定下來。SRE 通常分三個層次來定義:
| 指標 | 全稱與核心問題 | 具體範例 | 主要用途 |
|---|---|---|---|
| SLI | 服務水準指標 (我們現在跑得如何?) |
HTTP 200 成功率(99.85%)、P99 延遲低於 200ms、處理吞吐量 | 系統即時監控數據的客觀度量數值 |
| SLO | 服務水準目標 (我們對內的目標底線?) |
過去 30 天內 API 成功率必須 ≥ 99.9% | 開發與維運共同認可的健康基準與決策錨點 |
| SLA | 服務水準協議 (對外沒達標要賠多少錢?) |
單月可用性低於 99.5% 則退還客戶 10% 服務費 | 法務與商務合約,通常門檻寬鬆於 SLO |
實務上 SLI 最常看的幾個維度:
- 成功率(Availability / Correctness):有效請求與錯誤回應的比例(例如:API HTTP 5xx 佔比)。
- 回應延遲(Latency):請求耗時的百分位數(建議看 P95、P99,而不是毫無意義的平均值)。
- 處理容量(Capacity / Throughput):系統在峰值負載下的處理極限與飽和度(CPU、記憶體、I/O 佇列)。
02. 錯誤預算(Error Budget)是怎麼運作的
錯誤預算大概是 SRE 裡面最反直覺、但也是最實用的東西。
假設團隊定義某核心服務的 SLO 為 99.9% 的可用性,這意味著:我們擁有 0.1% 的不可用額度。在一個月(43,200 分鐘)裡,這相當於大約 43.2 分鐘的「容許停機/異常時間」。
如果每個月錯誤預算都剩 100%,代表團隊步調可能太保守了。這筆額度本來就是預留給快速發布新功能、重構舊程式碼或做故障演練的容錯空間。
當錯誤預算被消耗時,團隊的應對規則很明確:
- 預算充裕時:產品與開發團隊可以放心推新功能,即使偶爾有小波動也在預期內。
- 預算耗盡時(可用性跌破 SLO):觸發煞車機制。暫停非緊急的新功能上線,優先修復架構漏洞、補測試與調整監控。
- 預算重置週期:通常以滾動 30 天或季度為單位重置,兼顧開發進度與系統穩定。
推行錯誤預算最怕業務端不認帳:「為什麼超標就要暫停上線?」所以錯誤預算的規則必須事先跟產品負責人達成協議。唯有把「煞車機制」制度化,系統才不會被技術債壓垮。
03. 不究責事後檢討(Blameless Post-mortem)
當事故真的發生了,傳統文化往往忙著找人扛責:「誰寫出這行 Bug 的?誰按錯指令的?」
SRE 的出發點是:人一定會犯錯。如果一個人的單純失誤就能讓整個生產環境停擺,那真正有問題的是「系統防呆與流程設計」,而不是那個人。
不究責檢討會的重點在於防呆機制與流程改進:
- 還原客觀時序:記錄從告警觸發、排查到恢復的詳細時間點。
- 追問根本成因(Root Cause):連續問 5 個 Why。不是問「誰做了什麼」,而是問「系統為什麼允許這種危險操作直接在生產環境生效?」
- 落實改善事項:是否需要加上限流熔斷?CI 流程要補什麼檢查?監控告警有沒有及時通知到負責人?
只有在「誠實坦白不會被秋後算帳」的情況下,工程師才敢把真正踩雷的盲點講出來。把每次事故的教訓變成防呆機制與監控告警,以後遇到類似情況就不會再倒一次。
04. 小結
SLI/SLO 管住數據,不究責檢討管住團隊信任,兩件事缺一不可。
系統不可能永遠不壞,但只要指標明確、遇到故障能坦然檢討並補強防呆,系統就會越來越穩定。這才是 SRE 最實際的價值。
